04
四道分水岭题
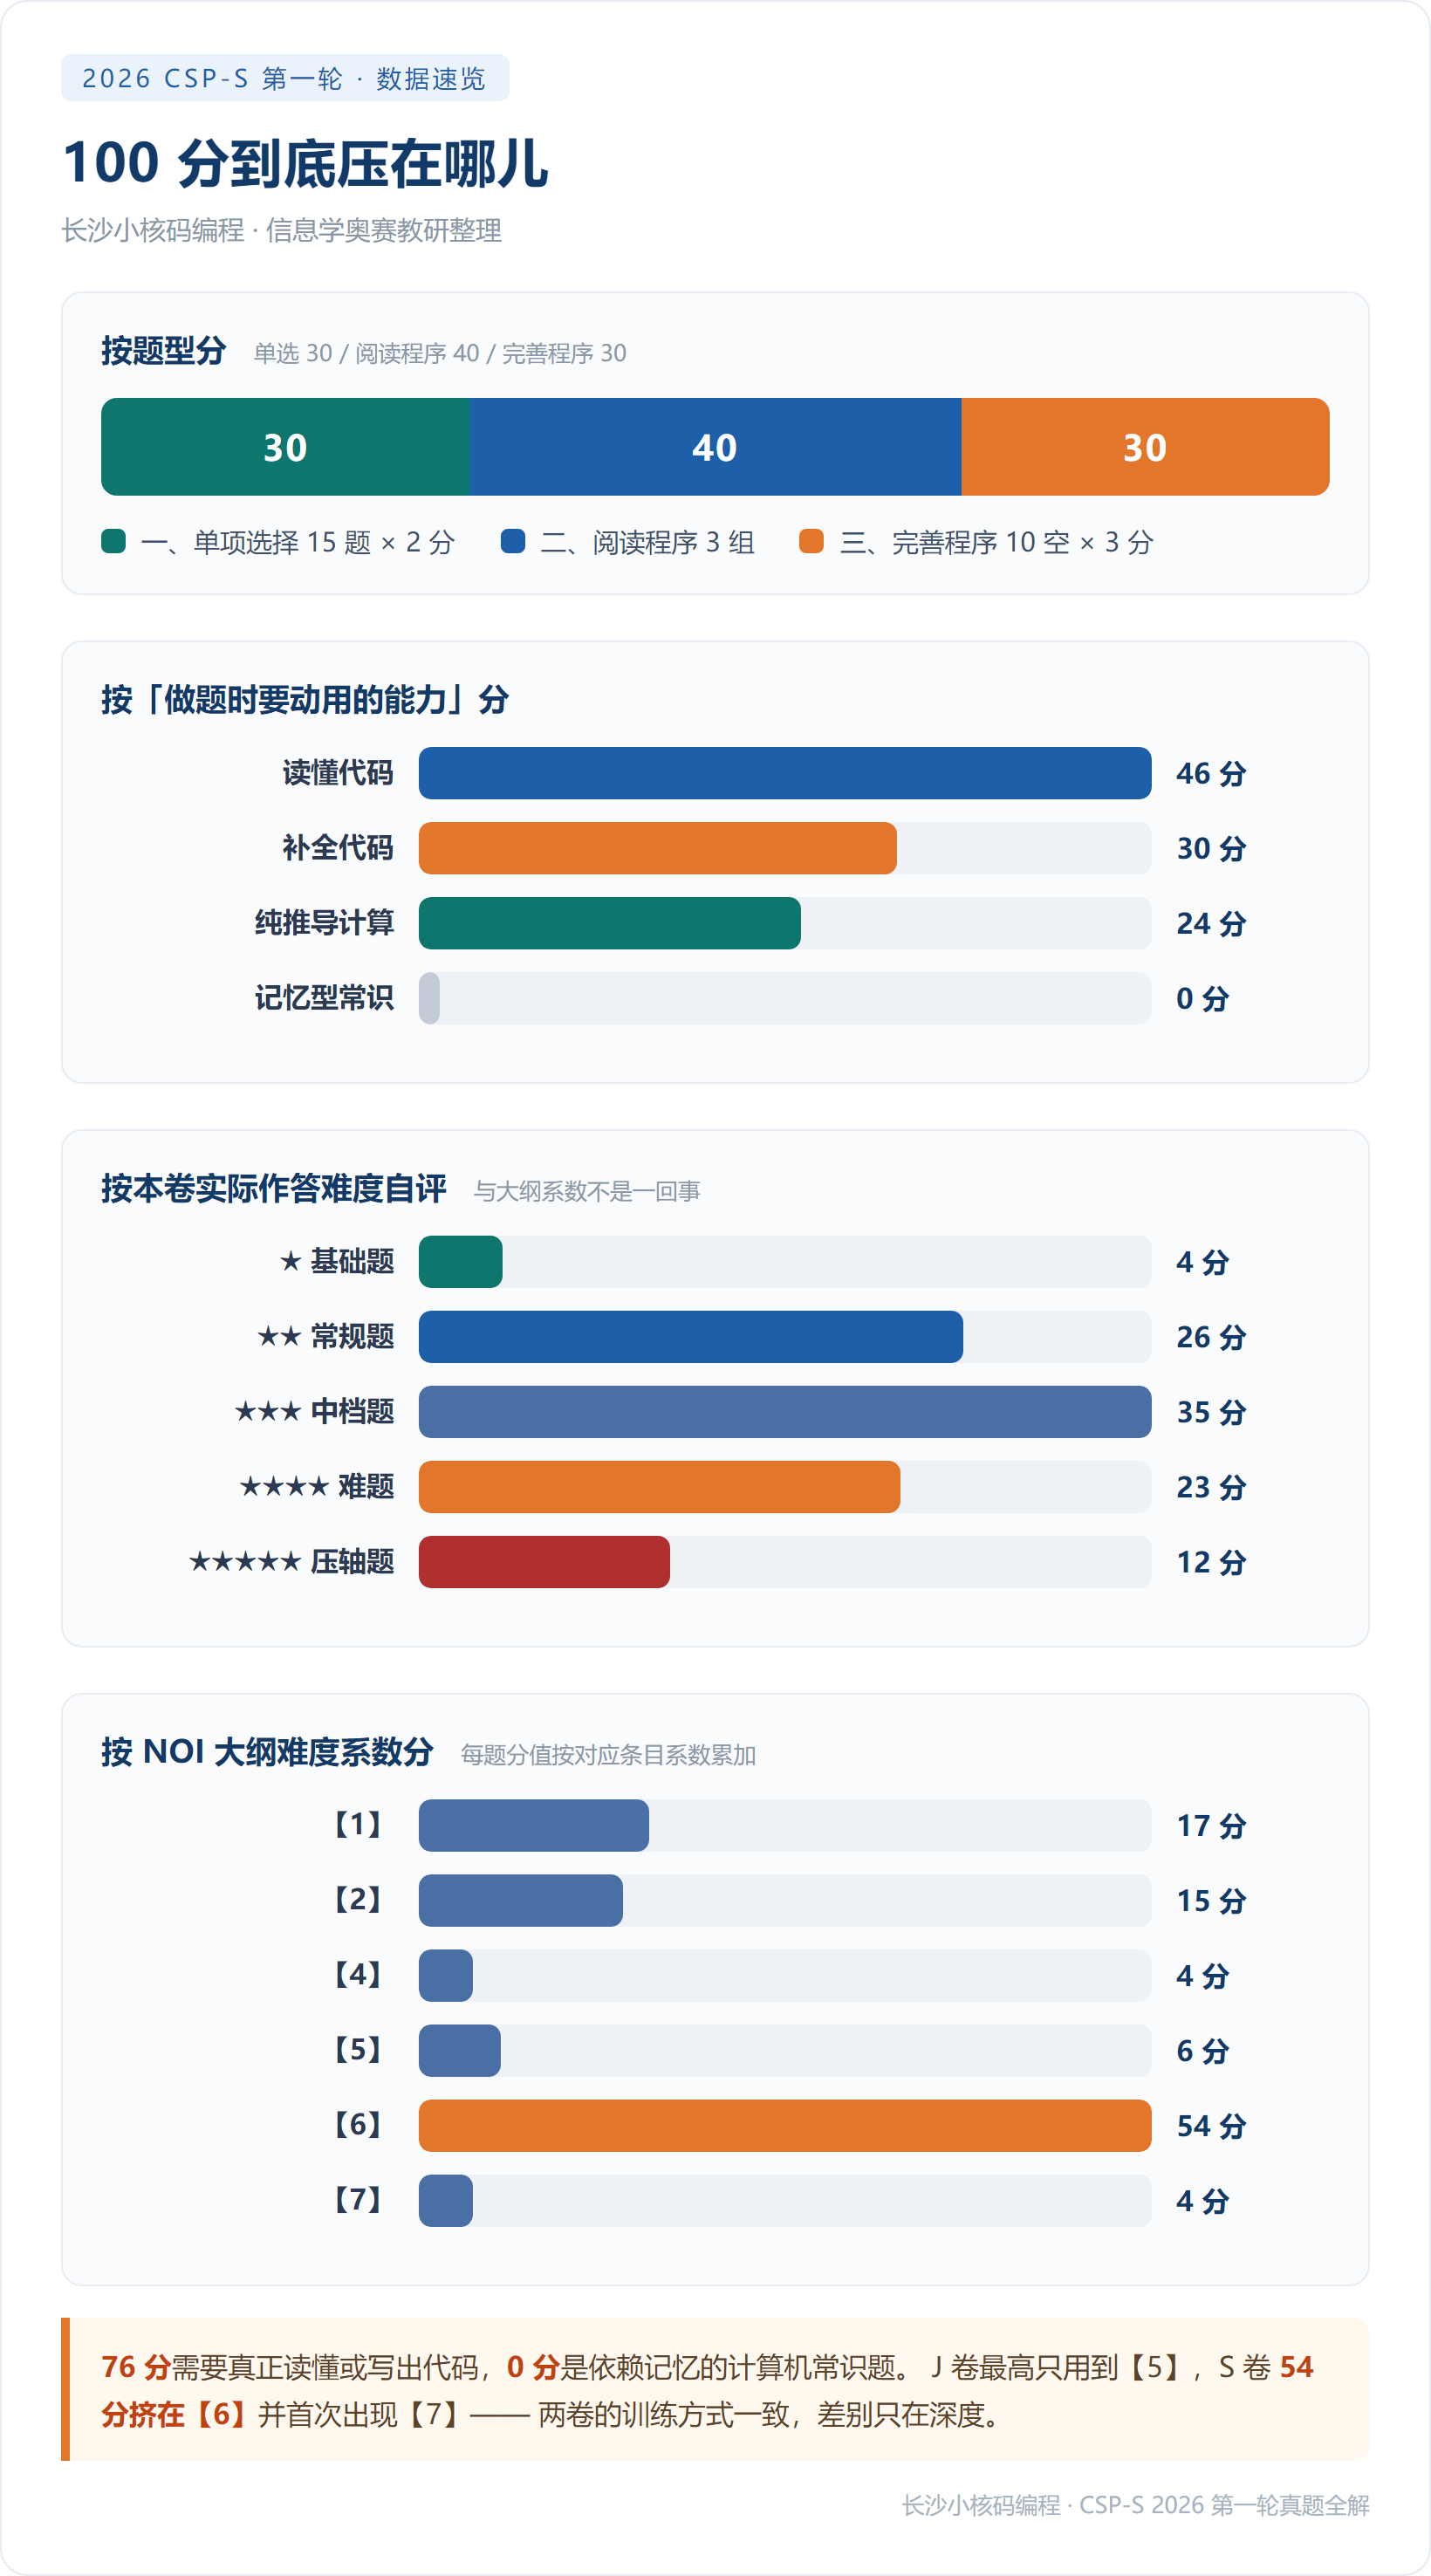
这四道题决定了 12 分的差距,也决定了「看懂」与「做对」之间的那道坎。
四道题都是 ★★★★★,每题 3 分,合计 12 分。它们的共同点是:不需要任何新知识,考的是愿不愿意在「看起来会了」之后再多推一步。
第 21 题3 分 · ★★★★★ · 读懂代码
删掉一句 continue,程序居然还能跑
卡在哪第 16 行的 if (a[i] == 0) continue; 是这段模 2 除法(CRC)的「守卫」。删掉它,程序不会崩、不会越界,照样输出一个 12 位的 '0'/'1' 串——所以很多同学会误判成「基本没影响」。
怎么破关键在于:删掉守卫后,每个 i 都会无条件异或一次 gen,整段程序变成一个与输入无关的固定操作。用程序跑 50 组随机输入,输出永远是同一个串 100000000101——这正是选项 C 说的「能正常输出,但结果与输入 s 无关」。看到「删一句」的题,先问自己:删掉的这句承担了什么职责?
第 33 题3 分 · ★★★★★ · 组合计数
要数的是「有多少种输入」,不是「有多少种输出」
卡在哪题面:n = 10 时,输出为 9 的合法输入有多少种?输出 9 意味着直径恰好是 9——十棵树里最长的路径要覆盖全部 10 个点,也就是这棵树必须退化成一条链。
怎么破把「树是一条链」翻译成父指针语言:整棵树就是「以 1 为根、两条链挂在 1 上」,而每个点的父结点编号比它小,所以每条链内部的顺序是被唯一确定的——只要决定 2~10 这 9 个点各自归左边还是右边,就唯一确定一种输入。左右互换得到同一棵树,故为 2^9 / 2 = 256 种(选项 C)。本题被穷举程序完整验证:全部 362880 种合法输入里,恰好 256 种输出 9。
第 38 题3 分 · ★★★★★ · 补全代码
最后一个空填的不是代码,是结论
卡在哪平衡路线的程序,前半段是标准的 BFS + 二分图染色,好写;难的是最后一句:if (⑤) cout << 0; else cout << 1;。四个选项都是「ok 与 c[s] == c[t] 的布尔组合」,看不出对错的区别,只能靠推理。
怎么破两条线索。①若图是二分图(ok 为真),从 s 到 t 的所有路线长度同奇偶,权值也同奇偶——距离为偶数时才可能凑出 0,对应 c[s] == c[t];②若图非二分(ok 为假),存在奇环,长短两条路线的奇偶性都能凑出来,再配合两种符号的边,一定能把权值凑成 0。两条合起来就是 (!ok) || (c[s] == c[t])(选项 C)。用 800 组随机小图,把选项代进程序与暴力搜索逐一对照,只有这一组零偏差。
第 43 题3 分 · ★★★★★ · 补全代码
等号放在哪边,全靠奇偶性
卡在哪第 43 空是 if (⑤) res[j] = 'A'; else res[j] = 'B';,而四个选项是 v >= (n & 1)、v > (n & 1)、v + (n & 1) >= 0、v * (n & 1) >= 0——看上去都很像,甚至有一项在大部分情况下都对。
怎么破v 是 n 个 ±1 的和,所以 v 与 n 同奇偶:n 为奇数时 v 必为奇数,永远不会等于 0;n 为偶数时 v 可能为 0。要让这一题取到最优,就得让 v 与所选的 s[j] 同号,即当选 A 时希望 v > 0(n 奇数)或 v ≥ 0(n 偶数)——恰好就是 v >= (n & 1)(选项 A)。其余三项在 n 为奇数且 v = 1 时会选错,输出的标准答案不再最优。
05
单项选择题 1—15
15 题共 30 分。难点集中在第 6、9、11、14 题:小规模时贪心与最优解常常一致、递归树每层和恒定、比较符一改动口径就变。
第 1 题位运算 · 二进制 1 的个数★★2 分
执行下列代码后,cnt 的值是( )。
int x = 2026, cnt = 0;
while (x) {
    x &= x - 1;
    cnt++;
}答案D
x & (x-1) 的作用是消掉 x 的二进制里最低位的那一个 1:减 1 会把最低位的 1 变 0、并把右边的 0 全部变成 1,再按位与,这一位连同右边的变化就一起被抹掉了。所以循环每转一圈消掉一个 1,cnt 数出来的正是 2026 的二进制中 1 的个数。
2026 = 1024+512+256+128+64+32+8+2,写作二进制是 11111101010,共 8 个 1,故 cnt = 8,选 D。
易错选项 C 的 11 是「2026 的二进制位数」,属于典型干扰项——位数和 1 的个数是两回事。
2.1.2-4 位运算(& | ~ ^ >> <<)【2】2.2.4-1 时间复杂度分析【6】
第 2 题哈夫曼树的构造与带权路径长度★★★2 分
用权值 {1, 2, 3, 4, 5, 6, 7, 8} 构造哈夫曼树,其带权路径长度是( )。
答案D
哈夫曼树有一个很好用的结论:带权路径长度 = 所有非叶结点(每步合并出来的新结点)权值之和。所以不必真把树画出来,只要按贪心反复取最小的两个相加,再把每次的和累加即可。
合并过程:1+2=3 → 3+3=6 → 4+5=9 → 6+6=12 → 7+8=15 → 9+12=21 → 15+21=36。累加 3+6+9+12+15+21+36 = 102,选 D。
易错每一步都要把新结点放回集合重新排序;另外别忘了最后那次 36(根结点)也要计入。
2.1.3-3 哈夫曼树的构造与编码【4】2.1.4-3 贪心算法【3】
第 3 题数位分类计数★★2 分
把 1 到 1000 的所有整数按十进制写出,数字「1」总共出现了多少次( )。
答案C
按数位分类计数,不要按数字一个个枚举。1 到 999 每个数都有百、十、个三个数位;固定某一位为 1,另外两位各有 10 种取法,所以每一位上出现 1 的次数都是 100。
三个数位合计 300 次,再加上 1000 里那一个 1,共 301 次,选 C。
易错两个常见错法:漏掉 1000;把「含有 1 的数的个数」当成「1 出现的次数」(例如 11 要算两次)。
2.1.5-1 进制与转换 / 数及其运算【1】2.2.5-3 离散与组合数学【6】
第 4 题错排列 + 组合★★★2 分
将 5 封信随机装入 5 个写好地址的信封(每封一个),恰好有 2 封装对的方案数是( )。
答案D
分两步:先选出哪 2 封装对,再让剩下的 3 封全部装错。
选 2 封有 C(5,2) = 10 种;3 个元素的错排 D₃ = 2(只可能是 231 与 312)。10 × 2 = 20,选 D。
易错选项 C 的 10 只完成了「选哪 2 封装对」这一步;选项 A 的 44 是「5 封信全部装错」(错排 D₅)的方案数,与题意无关。
2.2.5-3 错排列、圆排列【6】2.1.5-4 排列与组合【4】
第 5 题同余 · 找循环节★★2 分
3^2026 mod 100 的值是( )。
答案A
求幂取模先找循环节。3¹⁰ = 59049 ≡ 49,49² = 2401 ≡ 1,所以 3²⁰ ≡ 1 (mod 100),3 的幂模 100 以 20 为周期。
2026 = 20 × 101 + 6,因此 3^2026 ≡ 3⁶ = 729 ≡ 29(mod 100),选 A。
易错别错用「4 为周期」(那是 mod 10 的规律);也不要把指数写成 3^6 = 729 就直接作答——取模后再报数。
2.2.5-2 同余式【5】2.1.4-3 倍增法【4】
第 6 题区间 DP(线形合并)★★★★2 分
有 5 堆石子排成一行,重量依次为 4, 1, 3, 2, 5。每次只能把相邻的两堆合并成一堆,代价为这两堆重量之和。将所有石子合并成一堆的最小总代价是( )。
答案C
这是线性相邻合并,不能贪心——本题的贪心解恰好是 35,比最优解大(见「易错」)。正确做法是区间 DP:设 f[i][j] 为把第 i 到第 j 堆合成一堆的最小代价,则 f[i][j] = min{ f[i][k] + f[k+1][j] } + (a[i]+…+a[j])。
按区间长度递推:长度 2 得 5、4、5、7;长度 3 得 [1,3]=12、[2,4]=10、[3,5]=15;长度 4 得 [1,4]=20、[2,5]=24;最后 [1,5] = min(24, 5+15, 12+7, 20) + 15 = 34,选 C。
易错贪心(每次合并当前最小的一对)得到 4+6+10+15 = 35,与最优解 34 只差 1——小规模时贪心常常「看上去对」,这正是本题的陷阱。
2.1.4-9 区间类型 DP【5】2.1.4-3 贪心算法【3】
第 7 题树状数组的下标访问★★★2 分
树状数组维护长度 n = 16 的序列。查询前缀和 sum(11) 与单点修改 add(3, x) 分别需要访问树状数组中多少个下标( )。
答案A
树状数组两个操作的跳法是固定的:查询 sum(i) 每次 i -= i & -i(lowbit),修改 add(i) 每次 i += i & -i,后者一直跳到下标超过 n 为止。
sum(11):11 → 10 → 8 → 0,共 3 个下标;add(3):3 → 4 → 8 → 16,共 4 个下标。选 A。
易错两个方向别记反;另外 add 的跳法只与 n 有关,本例 n = 16 是 2 的幂,恰好跳到 16 就停。
2.2.3-3 树状数组【6】2.2.4-1 时间复杂度分析【6】
第 8 题拓扑序计数★★★2 分
有向无环图 G 顶点集为 {1, 2, 3, 4},边集为 {(1,2), (1,3)},顶点 4 与任何顶点均不相邻。该图不同的拓扑序共有多少种( )。
答案B
顶点 4 是孤立点,它与 1、2、3 之间没有任何先后约束;而 1 必须排在 2、3 之前。
先排 {1,2,3}:只有 1,2,3 与 1,3,2 两种。再把 4 插进这三个点形成的 4 个空位(最前、两处中间、最后),每种排法有 4 种插法。2 × 4 = 8,选 B。
易错不要把孤立点当成「必须放最后」;也不必担心重复——4 插入的位置唯一确定一个序列。
2.2.4-7 有向无环图的拓扑排序【6】2.1.5-4 排列与组合【4】
第 9 题分治算法的复杂度分析★★★★2 分
某分治算法满足 T(n) = T(n/3) + T(2n/3) + Θ(n),T(1) = O(1),则 T(n) 是( )。
- AΘ(n log n)
- BΘ(n²)
- CΘ(n^1.5)
- DΘ(n)
答案A
这类式子最稳的做法是画递归树。每一层所有子问题的规模之和恒为 n(n/3 + 2n/3 = n),所以每层的加工代价都是 Θ(n)。
再看深度:规模大于等于 1 就必须继续分,每次乘以 2/3,深度为 log_{3/2} n。总代价 = Θ(n) × Θ(log n) = Θ(n log n),选 A。
易错左右两个子问题规模不相等,不能套用「等分」的直觉;只要确认「每层和恒为 n」而深度是对数级,就锁定 Θ(n log n)。
2.2.4-3 分治算法【6】2.2.4-1 时间复杂度分析【6】
第 10 题树的重心与直径★★★2 分
无根树含 9 个结点(编号 1—9),边集为 {(1,2), (1,3), (2,4), (2,5), (3,6), (6,7), (7,8), (5,9)}。该树的直径(以边数计)与重心分别是( )。
- A直径 6,重心为结点 3
- B直径 7,重心为结点 2
- C直径 8,重心为结点 1
- D直径 7,重心为结点 1
答案D
先把树画出来:1 连 2、3;2 连 4、5;5 连 9;3 连 6;6-7-8 是一条链。最长的一条路是 9-5-2-1-3-6-7-8,经过 7 条边,故直径 7。
重心定义为「删掉它后,剩下的每个连通块都不超过 n/2」。删结点 1 得到 {2,4,5,9} 与 {3,6,7,8},两块都是 4 个点,都不超过 4.5;n = 9 是奇数时重心唯一,故重心就是结点 1。选 D。
易错选项 B 把重心说成结点 2——删掉 2 之后剩下 {1,3,6,7,8} 共 5 个点,超过一半,不合格;另外直径要按边数数,数成结点数会得到 8。
2.2.4-7 树的重心、直径、DFS 序与欧拉序【6】
第 11 题强连通分量(缩点后加边)★★★★2 分
一张有向图缩点后得到的有向无环图含 6 个顶点,其中入度为 0 的顶点有 3 个、出度为 0 的顶点有 4 个。为使原图变成强连通图,至少需要添加多少条有向边( )。
答案C
缩点后成为 DAG,让它强连通有一个干净的结论:最少加边数 = max(入度为 0 的顶点数, 出度为 0 的顶点数)——把每个「只出不进」的点接向每个「只进不出」的点,形成一个大环即可。
本题源点 3 个、汇点 4 个,故最少 4 条边,选 C。
易错答 3 只能保证源点都有入边,仍会有汇点收不到;而结论有个例外——若缩点后只有一个点(原图已强连通),答案是 0。
2.2.4-7 强连通分量【7】2.2.3-4 连通图与强连通图【7】
第 12 题卡特兰数★★★2 分
含 6 个结点的不同形态的二叉树共有多少棵(结点不带标号,区分左右子树)( )。
答案C
n 个结点的不同形态二叉树(区分左右子树)的个数正是卡特兰数:Cₙ = C(2n, n) / (n+1)。
n = 6 时:C(12,6) = 924,924 ÷ (6+1) = 132,选 C。
易错选项 B 的 429 是 n = 7 的结果,容易「差一格」;若题目改成「不区分左右子树」,计数方式完全不同,数值会小很多。
2.2.5-3 卡特兰数【7】2.1.3-2 二叉树定义与性质【3】
第 13 题字符串前后缀匹配(KMP 的 border)★★★2 分
字符串 S = 「ababaabab」,其所有既是真前缀又是真后缀的子串(非空)的长度之和是( )。
答案B
逐长度检查。长度 1:前缀 a 与后缀 b 不符;长度 2:ab 与末尾 ab 相符 ✓;长度 3、5、6、7、8 都不符;长度 4:abab 与末尾四位 abab 相符 ✓。
符合条件的长度是 2 和 4,和为 6,选 B。(这正是 KMP 的 border 链:π(9) = 4,沿 π(4) = 2、π(2) = 0 一路回退。)
易错「真」前缀/真后缀要求长度小于原串,所以 9 不算;另外这类题要找全部 border,不能只找最长的那一个(本题恰恰有两个)。
2.2.4-5 字符串匹配:KMP 算法【6】
第 14 题归并排序统计逆序对(改造比较符)★★★★2 分
用归并排序统计逆序对,合并部分的判断条件由 a[i] <= a[j] 改成 a[i] < a[j],则 ans 统计出的结果是( )。
// 归并 a[l..mid] 与 a[mid+1..r],同时累加逆序对
if (a[i] <= a[j]) {
    tmp[k++] = a[i++];      // 取左半段元素
} else {
    tmp[k++] = a[j++];      // 取右半段元素
    ans += mid - i + 1;
}- A完全不变
- B变为原来的两倍
- C变为满足 i < j 且 a[i] >= a[j] 的数对个数
- D变为原来的一半
答案C
原写法里,只有 a[i] > a[j] 才走 else 分支并累加 mid - i + 1,统计的是严格逆序对(i < j 且 a[i] > a[j])。
改成 a[i] < a[j] 后,a[i] == a[j] 也会走左分支、不再计数;于是只有 a[i] >= a[j] 才累加——统计对象变成i < j 且 a[i] ≥ a[j] 的数对,选 C。
易错相等的数对被「翻」进了统计口径,所以 A 不对;差额恰好是相等数对的个数,只有数组元素互不相同时两种写法结果才一样。
2.2.4-4 归并排序【5】2.2.4-1 时间复杂度分析【6】
第 15 题快速幂取模(手工模拟)★★2 分
执行 power(2, 100, 1000) 调用下列函数,返回值是( )。
long long power(long long a, long long b, long long p) {
    long long r = 1 % p;
    while (b) {
        if (b & 1) r = r * a % p;
        a = a * a % p;
        b >>= 1;
    }
    return r;
}答案B
这是快速幂:把指数 100 看成二进制 1100100,按「平方—乘」交替执行——b 的最低位为 1 时把当前的 a 乘进结果,每轮 a 自平方、b 右移一位。
手工算中间量(模 1000):2¹⁰ = 1024 ≡ 24;2²⁰ ≡ 24² = 576;2⁴⁰ ≡ 576² = 331776 ≡ 776;2⁸⁰ ≡ 776² = 602176 ≡ 176;于是 2¹⁰⁰ = 2⁸⁰ × 2²⁰ ≡ 176 × 576 = 101376 ≡ 376,选 B。
易错取模的模数是 1000(不是 100);另外 r = 1 % p 这个写法是为了处理 p = 1 的边界,说明命题人在细节上很讲究。
2.1.4-3 倍增法【4】2.2.5-2 同余式【5】
06
阅读程序 16—33
三组程序共 40 分。这里没有一个空是靠背知识填的——第 20、21 题考算法本质与守卫的作用,第 27 题考取整方向,第 33 题考「数输入」。
阅读程序(1)· 二进制模 2 除法
16—21 题,共 13 分(第 16 题 1 分,17—18 题各 1.5 分,19—21 题各 3 分)
程序代码
01 #include <iostream>
02 #include <string>
03 using namespace std;
04 int a[100];
05 string s;
06 int gen[13] = {1, 1, 0, 0, 0, 0, 0, 0, 0, 1, 1, 1, 1};
07 int main() {
08     cin >> s;
09     for (int i = 0; i < 32; ++i) {
10         a[i] = s[i] - '0';
11     }
12     for (int i = 32; i < 44; ++i) {
13         a[i] = 0;
14     }
15     for (int i = 0; i < 32; ++i) {
16         if (a[i] == 0) continue;
17         for (int j = 0; j < 13; ++j) {
18             a[i + j] ^= gen[j];
19         }
20     }
21     for (int i = 32; i < 44; ++i) {
22         cout << a[i];
23     }
24     cout << endl;
25     return 0;
26 }
说明:输入保证为一个长度恰为 32 的 '0'/'1' 字符串。
读题要点
- 输入是一个长度恰为 32 的 '0'/'1' 串;第 9—11 行把每一位存进 a[0..31](a[0] 是最高位),第 12—14 行把 a[32..43] 清 0。
- 核心在第 15—20 行:从最高位往低位扫,遇到 1 就把 gen 对齐着异或一次,把它消成 0。这是模 2 多项式除法(二进制长除法)的标准写法。
- 补 12 个 0 相当于把输入左移 12 位,即算 M × 2¹²;除数是 13 位的 1100000001111。
- 输出 a[32..43],就是这次除法的 12 位余数——与 CRC 校验的做法完全一致。
本组知识点
2.1.2-4 位运算(& | ~ ^ >> <<)【2】2.1.5-1 进制与转换【1】2.1.4-2 模拟法【1】
逐题解析
第 16 题判断题 · 12 个 0★1 分
(1 分)当输入为 32 个 '0' 时,程序输出 12 个 0。
答案√
全 0 输入时,每一位都满足 a[i] == 0,第 16 行的 continue 会让 32 次循环全部被跳过;a[32]~a[43] 保持补零循环写进去的 0,于是输出 12 个 '0'。√
易错本题是全卷唯一一道 1 分题(题面特别注明),也是最容易的一道——白送的分不要丢。
2.1.4-2 模拟法【1】2.1.2-4 位运算【2】
第 17 题判断题 · 循环不变量★★★1.5 分
程序运行结束后,数组 a 中下标从 0 到 31 的元素一定全部为 0。
答案√
看下标的「方向性」:第 i 轮循环(i 从 0 到 31 递增)只可能修改下标 ≥ i 的位置(a[i+j] ^= gen[j],j ≥ 0)。所以第 i 轮结束时 a[i] 已经变成 0,而后续 i′ > i 的轮次只会影响下标 ≥ i′,再也碰不到 a[i]。
一位一位看下来,每处理完一位它就永久归零,故最终 a[0..31] 全为 0。√(用 200 组随机 32 位串复核,全部成立。)
易错这是「循环不变量」型的判断:不要只看单轮,要看后续轮次会不会回头改。
2.1.4-2 模拟法【1】2.2.4-1 时间复杂度分析【6】
第 18 题判断题 · 全局数组的初值★★★★1.5 分
若将第 12~14 行(为 a[32] 到 a[43] 补 0 的循环)删除,会改变程序输出结果。
答案×
关键在第 04 行:int a[100]; 写在 main 之外,是全局数组,程序启动时已被零初始化——a[32] 到 a[43] 本来就是 0。
补零循环只是把「本来就是 0」这件事明写了一遍,删掉之后每一步得到的中间状态完全相同,输出不会变。×
易错看到「删掉一行会不会影响结果」,第一件事是确认这个变量是全局还是局部:全局自带零初值,局部则是随机垃圾值——同一道题换一种声明位置,答案就反过来。
2.1.2-2 常量与变量作用域【2】2.1.4-2 模拟法【1】
第 19 题单选题 · 除数数组★★3 分
关于第 6 行定义的数组 gen,下列说法正确的是( )。
- Agen 共有 12 个元素,表示一个 12 位的除数
- Bgen 共有 13 个元素,表示一个 13 位的被除数
- Cgen 共有 13 个元素,其中 gen[0] 是除数的最高位
- Dgen 共有 13 个元素,其中 gen[12] 是除数的最高位
答案C
int gen[13] = {1, 1, 0, 0, 0, 0, 0, 0, 0, 1, 1, 1, 1}; 共 13 个元素,取值依次拼起来就是 1100000001111。
程序在第 18 行用 a[i + j] ^= gen[j] 去消掉当前最高位 a[i],说明 gen[0] 与 a[i] 对齐——gen[0] 就是除数的最高位。选 C。
易错选项 D 把顺序倒过来。判断最高位在哪一头的方法很简单:看它与被除数的哪一端对齐。
2.1.5-1 进制与转换【1】2.1.4-2 模拟法【1】
第 20 题单选题 · 识别算法本质★★★★3 分
该程序实现的功能,最准确的说法是( )。
- A将输入的 32 位串看成二进制数 M,输出 M 与 13 位二进制数 1100000001111 按位异或的结果
- B将输入串视为 32 位二进制数 M,在其后补 12 个 0(即计算 M × 2¹²),再对它用 1100000001111 作模 2 除法求余数,并输出 12 位余数
- C对输入的 32 位串逐位取反并输出结果
- D统计输入串中 1 的个数,并把该个数用 12 位二进制表示后输出
答案B
第一步是「补 12 个 0」:把 M 的每一位依次写进 a[0..31],再令 a[32..43] = 0,等价于把 M 左移 12 位,即 M × 2¹²。
第二步是「见 1 就异或一次 gen」:这是模 2 多项式除法的标准写法(与二进制长除法、CRC 校验完全一致)——从最高位开始,若当前位是 1 就把除数对齐着异或一次,把它消成 0 再往右走。除数是 13 位的 1100000001111,除完剩下的低 12 位就是余数,也正是程序的输出。选 B。
易错选项 A 只说对了一半(异或确实发生了),但它没有说清「异或的条件与位置」,更没有体现「移位 + 取余」这个完整语义——这正是「动作对、说法错」的典型伪答案。
2.1.2-4 位运算【2】2.1.5-1 进制与转换【1】
第 21 题单选题 · 删掉守卫之后★★★★★3 分
若将第 16 行 if (a[i] == 0) continue; 删除,说法正确的是( )。
- A程序输出的结果不会改变
- B可能造成程序运行错误
- C程序能够正常输出一个 12 位 '0'/'1' 串,但是输出结果与输入的 s 无关
- D程序运行结束后,a[0] 的值一定为 0
答案C
删掉守卫后,每个 i 都会无条件执行 a[i + j] ^= gen[j],不再依赖 a[i] 的值。此时 a[32..43] 的初值恒为 0,而每位被异或的次数只由 i、j 的循环次数决定——整段程序变成一个与输入 s 完全无关的固定操作。
实测:50 组随机输入,输出永远是同一个串 100000000101。程序不会崩、也不会越界(最大下标 43 < 100),但结果与 s 无关。选 C。
易错这类「删一句」的题,最容易错在「看着差不多」:程序仍然正常输出,所以 A 很诱人。真正的判据是——被删掉的那句承担了什么职责?它守的是「除法的前置条件」。
2.1.4-2 模拟法【1】2.2.4-1 时间复杂度分析【6】
阅读程序(2)· ST 表求区间 gcd
22—27 题,共 13.5 分(22—24 题各 1.5 分,25—27 题各 3 分)
程序代码
01 #include <iostream>
02 using namespace std;
03 int n, m, a[100007], L, R, lg[100007], i, j, t, dp[100007][25], pw[25];
04 int gcd(int x, int y) {
05     if (y == 0) return x;
06     return gcd(y, x % y);
07 }
08 int main() {
09     cin >> n >> m;
10     for (i = 1; i <= n; i++) cin >> a[i];
11     t = 0;
12     pw[0] = 1;
13     for (i = 1; i <= 24; i++) pw[i] = pw[i - 1] * 2;
14     for (i = 2; i <= 100000; i++)
15         if (pw[t + 1] >= i) lg[i] = t;
16         else t++, lg[i] = t;
17     for (i = 1; i <= n; i++)
18         dp[i][0] = a[i];
19     for (j = 1; j <= lg[n]; j++)
20         for (i = 1; i + pw[j] - 1 <= n; i++) {
21             dp[i][j] = gcd(dp[i][j - 1], dp[i + pw[j - 1]][j - 1]);
22         }
23     for (i = 1; i <= m; i++) {
24         cin >> L >> R;
25         cout << gcd(dp[L][lg[R - L + 1]], dp[R - pw[lg[R - L + 1]] + 1][lg[R - L + 1]]) << endl;
26     }
27     return 0;
28 }
说明:保证 1 ≤ n ≤ 100000,每次查询满足 1 ≤ L ≤ R ≤ n,且数组 a 的元素均为正整数。
读题要点
- 第 13—16 行预处理倍增数组:pw[i] = 2^i,lg[i] 记录「i 落在哪一层」。注意第 14 行从 i = 2 开始、第 15 行用的是
>= i——取整方向直接决定第 27 题。 - 第 17—22 行建表:dp[i][j] 表示从 a[i] 开始连续 2^j 个数的最大公约数,由两块 2^(j−1) 拼接而成。整体复杂度 Θ(n log n)。
- 第 23—26 行处理查询:取 k = lg[R − L + 1],用两块长度 2^k 的重叠区间覆盖 [L, R]。gcd 满足幂等性(重叠部分重复计算不影响结果),所以这样拼是正确的,每次查询只要 O(1) 次 gcd。
- 一句话总结:这是用倍增预处理把「区间 gcd 查询」从 O(n) 降到 O(1) 的经典结构(ST 表 / 稀疏表)。
本组知识点
2.2.3-1 ST 表(Sparse Table)【6】2.2.4-1 时间复杂度分析【6】2.1.5-3 辗转相除法(欧几里得算法)【3】
逐题解析
第 22 题判断题 · 样例模拟★★1.5 分
当 n = 5,a = {4, 2, 6, 3, 9},且仅有一次查询 L = 2、R = 5 时,输出为 1。
答案√
查询区间是 a[2..5] = {2, 6, 3, 9}:gcd(2, 6) = 2,gcd(2, 3) = 1,所以整个区间的 gcd 就是 1。程序用两块长度 2^k 的重叠区间覆盖查询,重叠保证了不漏任何元素,结果同样是 1。√
易错考场上的做法:先手算区间 gcd,再回来看程序的两块区间是否覆盖完整,通常 30 秒就能判。
2.2.3-1 ST 表(Sparse Table)【6】2.1.5-3 辗转相除法【3】
第 23 题判断题 · 边界(长度 1)★★1.5 分
当某次查询的区间长度为 1(即 L = R)时,这次查询的输出一定等于 a[L]。
答案√
长度 1 时 k = lg[1] = 0,两块区间都是 dp[L][0] = a[L],gcd(a[L], a[L]) = a[L]。√
易错一般的 ST 表题都爱考这个边界,记住结论:长度 1 时答案就是元素本身。
2.2.3-1 ST 表(Sparse Table)【6】
第 24 题判断题 · 大小关系★★1.5 分
任意一次查询的输出结果一定不小于该查询区间内的最小值。
答案×
区间 gcd 一定整除区间里的每一个数,因此它必然不大于区间最小值。题干写的是「不小于」,方向反了。
用 500 组随机数据检验,没有出现「gcd 大于区间最小值」的情形。×
易错「gcd 是所有元素的公共因数,所以 gcd ≤ 最小值」——这句话反过来说就错了,命题人常把不等式方向颠倒当陷阱。
2.1.5-3 辗转相除法【3】2.1.5-3 整除、因数、倍数【3】
第 25 题单选题 · dp 的含义★★3 分
对于 j ≥ 1,数组 dp[i][j] 保存的是( )。
- A从 a[i] 开始连续 j 个数的最大公约数
- B从 a[i] 开始连续 2^j 个数的最大公约数
- Ca[i] 与 a[j] 的最大公约数
- D从 a[1] 到 a[i] 的最大公约数
答案B
递推式是 dp[i][j] = gcd(dp[i][j-1], dp[i + pw[j-1]][j-1]),而 pw[j-1] = 2^(j-1):把两个长度 2^(j-1) 的块拼起来,正好覆盖连续 2^j 个数。所以 dp[i][j] 表示从 a[i] 开始的连续 2^j 个数的 gcd。选 B。
易错选项 A 是「长度 j」,把指数当成了长度——这正是倍增类 DP 最容易混的一处;j 是「二的幂次」,不是「元素个数」。
2.2.3-1 ST 表(Sparse Table)【6】
第 26 题单选题 · 建表复杂度★★★3 分
若把一次求最大公约数的运算视为 O(1),则第 17~22 行建表过程的时间复杂度为( )。
- AΘ(n)
- BΘ(n log n)
- CΘ(n²)
- DΘ(mn)
答案B
建表是两层循环:外层 j 从 1 到 lg[n] ≈ log₂n,内层 i 从 1 到 n − 2^j + 1。总运算次数约为 n·log n,每次 gcd 记为 O(1),故为 Θ(n log n)。选 B。
(每次查询只需 O(1) 次 gcd,与 m 无关;Θ(mn) 是「每次查询重新扫一遍区间」的朴素做法。)
易错选项 D 的 Θ(mn) 特意提了 m,是给「查询时才计算」的做法准备的干扰项——ST 表的价值恰恰在于把查询降到 O(1)。
2.2.4-1 时间复杂度分析【6】2.2.3-1 ST 表(Sparse Table)【6】
第 27 题单选题 · lg 数组的取整方向★★★3 分
设 x 为一次查询的区间长度(即 x = R − L + 1),则使得 lg[x] = 5 的 x 的取值范围是( )。
- A[16, 31]
- B[17, 32]
- C[32, 63]
- D[33, 64]
答案D
这段代码里的 lg 数组不是常见的「下取整」版本。盯住两处细节:循环从 i = 2 开始,判断写的是 pw[t + 1] >= i(带等号)。于是 t 只在 2^(t+1) 严格小于 i 时才增加,等价于 lg[i] = ⌈log₂ i⌉ − 1。
直接代入:lg[32] = 4(因为 2⁵ = 32 ≥ 32,t 还停在 4)、lg[33] = 5、lg[64] = 5、lg[65] = 6。所以 lg[x] = 5 的范围是 [33, 64],选 D。
关于第 27 题的题面分歧(请留意)
网传试卷在阅读程序(2) 的 lg 预处理上存在两种写法,两者只差一个等号:
① for (i = 1; ...) + if (pw[t+1] > i) —— 此时 lg[i] = ⌊log₂i⌋,lg[x] = 5 对应 [32, 63],应选 C;
② for (i = 2; ...) + if (pw[t+1] >= i) —— 此时 lg[i] = ⌈log₂i⌉ − 1,lg[x] = 5 对应 [33, 64],应选 D。
本文按流通较广的写法 ② 判定为 D;若你手上的试卷印的是写法 ①,请按 C 计分。两种写法均已用程序分别复算核对,除本题外其余 42 题两种版本答案完全一致。
易错若按常见的「下取整」版本 lg[i] = ⌊log₂ i⌋ 去算,会得到 [32, 63](选项 C)——这正是本题埋的差一陷阱,全部分歧都出在 >= 这个等号上。(两个版本的 lg 都能让 ST 表正确工作,所以命题人敢这么出。)
2.2.3-1 ST 表(Sparse Table)【6】2.2.4-1 时间复杂度分析【6】
阅读程序(3)· 树型 DP 求直径
28—33 题,共 13.5 分(28—30 题各 1.5 分,31—33 题各 3 分)
程序代码
01 #include <iostream>
02 using namespace std;
03 int n, fa[100007], f[100007], ans;
04 int main() {
05     cin >> n;
06     for (int i = 2; i <= n; ++i) {
07         cin >> fa[i];
08     }
09     for (int i = n; i >= 2; --i) {
10         if (f[fa[i]] + f[i] + 1 > ans) {
11             ans = f[fa[i]] + f[i] + 1;
12         }
13         if (f[i] + 1 > f[fa[i]]) {
14             f[fa[i]] = f[i] + 1;
15         }
16     }
17     cout << ans << endl;
18     return 0;
19 }
说明:输入第一行为结点个数 n,第二行为 n − 1 个整数,依次表示结点 2 ~ n 的父结点编号,满足 2 ≤ n ≤ 100000 且 1 ≤ fa[i] < i,根结点为 1。
读题要点
- 输入给出的是一棵树:第 i 个点的父结点编号满足 fa[i] < i,所以「编号大的点一定不会更靠上」。
- f[u] 表示以 u 为根的子树高度(以边数计);ans 最终表示整棵树的直径(最远两点的距离)。
- 第 9 行循环 i 从 n 递减到 2:因为 fa[i] < i,倒序处理等价于「先把儿子都算完,再算父亲」,无需递归。
- 第 10—12 行:用「i 这条腿的高度」+「父结点已统计过的另一条最好的腿」+ 1(连接它们的边)更新 ans——这就是「树型 DP 一次遍历求直径」的标准写法。第 13—15 行则把 f[fa[i]] 抬高到 f[i] + 1。
- 两句 if 的先后顺序不能换(第 30 题):先更新 ans 用的是旧的 f 值,交换后会把同一条链数两遍。
本组知识点
2.2.4-7 树的重心、直径、DFS 序与欧拉序【6】2.2.4-8 树型动态规划【6】
逐题解析
第 28 题判断题 · 链的模拟★★1.5 分
当 n = 5,fa[2] ~ fa[5] = {1, 2, 3, 4} 时,程序输出 4。
答案√
这组输入是一条链 1-2-3-4-5。程序从 i = n 递减处理,保证先算完儿子再算父亲:i=5:ans = 0+0+1 = 1,f[4] = 1;i=4:ans = 2,f[3] = 2;i=3:ans = 3,f[2] = 3;i=2:ans = 4,f[1] = 4。输出 4。√
易错注意循环是 i 从 n 递减到 2:题目保证 fa[i] < i,所以下标大的点一定是「更靠下」的点,倒序处理等价于「先子后父」。
2.2.4-7 树的重心、直径、DFS 序与欧拉序【6】2.2.4-8 树型动态规划【6】
第 29 题判断题 · f 与 ans 的关系★★★1.5 分
程序输出前,f[1] 的值一定等于 ans 的值。
答案×
两者含义不同:f[u] 是以 u 为根的子树高度(以边数计),ans 是整棵树的直径(最远两点间的边数),根的高度与全树直径一般不等。
反例:n = 3、fa[2] = fa[3] = 1 的星形树,f[1] = 1,而 ans = 2(叶子 2 → 1 → 叶子 3)。×
易错只有退化成一条链时两者才相等(此时 f[1] = ans = n−1),别被这种特例骗了。
2.2.4-7 树的重心、直径、DFS 序与欧拉序【6】
第 30 题判断题 · 交换两句 if★★★★1.5 分
将第 10~12 行与第 13~15 行两个 if 语句的顺序交换后,程序的输出结果不受影响。
答案×
原顺序是「先用旧的 f 值更新 ans,再抬高 f[fa[i]]」,两条腿算的是不同的儿子,互不干扰。
交换之后,抬高 f[fa[i]] 的那句先执行,ans 的计算就会用上「刚被自己这条腿抬上去的」值,等于把同一条链数了两遍。实测:n = 5 的链,原程序输出 4,交换后输出 8。×
易错这一类题的通用判断方法:把两个 if 的目标变量写出来——如果后一句会修改前一句所依赖的量,交换顺序就会改变结果。
2.2.4-8 树型动态规划【6】2.1.4-2 模拟法【1】
第 31 题单选题 · ans 的含义★★★3 分
程序输出的 ans 表示的是( )。
- A树中距离最远的两个结点之间路径所经过的边数
- B根结点 1 到最远叶子结点之间路径所经过的边数
- C树中叶子结点的个数
- D所有结点的父结点编号之和
答案A
处理结点 i 时,用 f[i](i 这条腿的高度)加上 f[fa[i]](父结点已统计过的另一条最好的腿),再加 1(连接它们的这条边)去更新 ans——求的正是「穿过边 (i, fa[i]) 的最长路径」。对每条边取一遍最大值,得到的就是全树直径。选 A。
(这就是「树型 DP 一次遍历求直径」的经典写法。)
易错选项 B 是「高度」,正好是本程序里 f[1] 的含义——注意区分 f 数组与 ans。
2.2.4-7 树的重心、直径、DFS 序与欧拉序【6】2.2.4-8 树型动态规划【6】
第 32 题单选题 · 再模拟一次★★3 分
当 n = 7,fa[2] ~ fa[7] = {1, 1, 2, 2, 3, 3} 时,输出为( )。
答案C
结构:1 的儿子是 2、3;2 的儿子是 4、5;3 的儿子是 6、7。最长路径形如 4-2-1-3-6,4 条边。
逐步模拟:i=7、6 把 f[3] 抬到 1、ans 到 2;i=5、4 把 f[2] 抬到 1;i=3 时 f[1] 变 2;i=2 时 ans = f[1] + f[2] + 1 = 2 + 1 + 1 = 4。选 C。
易错别把「叶子数 4」当成答案(选项 C 的 4 恰好也是这个数,属于巧合型的正确选项);要按程序逐步推,而不是猜。
2.2.4-7 树的重心、直径、DFS 序与欧拉序【6】
第 33 题单选题 · 数合法输入的种类★★★★★3 分
当 n = 10,满足输出为 9 的合法输入种类数为( )。
答案C
输出 9 说明直径是 9,而树里总共只有 10 个结点——要想最远的两点距离达到 9,这棵树必须退化成一条链(10 个点串成一线)。
把「树是一条链」翻译成父指针的语言:每个点的父结点编号都比它小,链上的先后顺序因此被唯一确定,整棵树完全取决于「2~10 这 9 个点各自归 1 的左边还是右边」;而左右互换得到的是同一棵树,故为 2⁹ ÷ 2 = 256 种。选 C。
(本题用穷举程序完整验证:全部 9! = 362880 种合法输入中,恰好 256 种使输出为 9。)
易错选项 D 的 512 就是漏掉「左右互换算同一棵树」这一步的结果;选项 B 的 9 是把它当成「随便挑一个点当叶子」。这类题的通用步骤是:先把条件翻译成「树长什么样」,再数「有多少种父指针写法」。
2.2.4-7 树的重心、直径、DFS 序与欧拉序【6】2.2.4-8 树型动态规划【6】
07
完善程序 34—43
两组程序、10 个空,共 30 分。第一组第 38 空填的是结论;第二组的五个空全部围绕一个想法:把绝对值写成 max(±y),再用格雷码枚举符号方案。
完善程序(1)· 平衡路线
34—38 题,每题 3 分,共 15 分
给定一张有 n 个顶点、m 条边的无向图,每条边带有符号 + 或 −。对于一条从顶点 s 到顶点 t 的路线(允许重复经过顶点和边),记 n₊、n₋ 分别为路线经过的 + 边数和 − 边数,则该路线的权值为 |n₊ − n₋|。
请计算从 s 到 t 的路线的最小权值。若不存在从 s 到 t 的路线,则输出 −1。
输入第一行为四个整数 n, m, s, t。接下来 m 行,每行给出两个整数 a, b 和一个字符 + 或 −,描述一条连接 a 与 b 的无向边及其符号。
数据满足 2 ≤ n ≤ 2×10⁵,1 ≤ m ≤ 4×10⁵,1 ≤ s, t ≤ n 且 s ≠ t,1 ≤ a, b ≤ n,可能出现重边。
程序代码
01 #include <iostream>
02
03 constexpr int N = 200005;
04 constexpr int M = 400005;
05
06 int n, m, s, t;
07 int h[N], e[M << 1], ne[M << 1], w[M << 1], idx;
08 int q[N], d[N], c[N];
09
10 void add(int a, int b, int z) {
11     e[idx] = b;
12     w[idx] = z;
13     ne[idx] = h[a];
14     h[a] = idx++;
15 }
16
17 int main() {
18     std::cin >> n >> m >> s >> t;
19     for (int i = 1; i <= n; i++)
20         h[i] = d[i] = c[i] = -1;
21     for (int i = 0; i < m; i++) {
22         int a, b;
23         char op[2];
24         std::cin >> a >> b >> op;
25         int z = ①;
26         add(a, b, z);
27         add(b, a, z);
28     }
29     int hh = 0, tt = 0;
30     int p = 0, ng = 0, ok = 1;
31     q[tt++] = s;
32     d[s] = c[s] = 0;
33     while (②) {
34         int x = q[hh++];
35         for (int i = h[x]; i != -1; i = ne[i]) {
36             int y = e[i];
37             if (w[i] > 0) p = 1;
38             if (w[i] < 0) ng = 1;
39             if (d[y] == -1) {
40                 d[y] = ③;
41                 c[y] = c[x] ^ 1;
42                 q[tt++] = y;
43             } else if (④)
44                 ok = 0;
45         }
46     }
47     if (d[t] == -1) {
48         std::cout << -1;
49         return 0;
50     }
51     if (!p || !ng) {
52         std::cout << d[t];
53         return 0;
54     }
55     if (⑤) std::cout << 0;
56     else std::cout << 1;
57     return 0;
58 }
读题要点
- 存储:链式前向星(h / e / ne / w),add() 用头插法。无向边要加两次,两次的权值相同。
- 主体是一遍 BFS:d[] 记录从 s 出发的最短边数;c[] 做二染色(相邻点异色),顺便判定图是否为二分图(标记变量 ok)。
- p / ng 分别记录「沿途见过 + 边」「见过 − 边」。若两者只有其一(整条连通块里符号单一),答案就是最短路长度 d[t]。
- 两者都出现时,答案只可能是 0 或 1,由「图是否二分」与「s、t 是否同色」共同决定——这就是第 38 题要填的结论。
本组知识点
2.1.4-7 广度优先搜索(BFS)【5】2.2.4-7 二分图的判定【6】2.2.3-4 偶图(二分图)【6】
逐题解析
第 34 题① 字符转符号★★3 分
① 处应填( )。
- A
op[0] == '+' ? 0 : 1 - B
op[0] == '+' - C
op[0] == '+' ? 1 : -1 - D
op[0] == '-' ? 1 : 0
答案C
题目要算的权值是 |n₊ − n₋|,而程序后面既用 if (w[i] > 0) p = 1 判断「有没有 + 边」,又用 if (w[i] < 0) ng = 1 判断「有没有 − 边」,还要让 w 参与符号运算——所以 w 必须是 +1 / −1。
选项 B 是布尔值 1/0:负号边会被记成 0,w[i] < 0 永远不成立,判断直接失效;A、D 的值域只有 {0, 1},同样不行。选 C。
易错本题把「字符 → 数值」设成第 1 空,属于送分;但要留意 B 这种「布尔值也是 1/0,看起来能用」的写法。
2.1.2-1 基本数据类型与运算【1】2.1.4-7 广度优先搜索(BFS)【5】
第 35 题② BFS 队列的循环条件★★★3 分
② 处应填( )。
- A
hh < n - B
tt < n - C
hh <= tt - D
hh < tt
答案D
队列用 q[tt++] = y 入队、x = q[hh++] 出队,所以 hh 指向队首、tt 指向队尾的后一格,「队列非空」的条件就是 hh < tt。选 D。
选项 C 在队列已空时会多取一个位置(那里是全局数组的 0),程序会以「编号 0 的伪结点」继续跑;选项 A 在「t 不可达、图不连通」时会多转很多圈,同样会读到无效位置——本组测试里它读到的恰好都是 0,所以「看着没错」,其实是运气。
易错BFS 的循环条件永远是「队首 < 队尾」,不要用点数 n 去卡;考试时若两个选项都能通过样例,选语义正确的那一个。
2.1.4-7 广度优先搜索(BFS)【5】2.1.3-1 队列【3】
第 36 题③ BFS 层数★3 分
③ 处应填( )。
- A
d[y] + 1 - B
d[x] + 1 - C
d[x] - D
d[x] - 1
答案B
d 数组记录从 s 出发经过的边数。y 是 x 的邻居,且此刻是第一次访问到 y,所以 d[y] = d[x] + 1,选 B。
A 里 d[y] 此刻还是 −1(未访问标记),写出来就是 −1 + 1 = 0;C 让所有点都停在第 1 层。
易错这是全卷最简单的一空(★ 级)——如果连它都要犹豫,说明 BFS 的基本写法还没写熟。
2.1.4-7 广度优先搜索(BFS)【5】
第 37 题④ 奇环判定★★★3 分
④ 处应填( )。
- A
c[y] == c[x] - B
w[i] == 1 - C
c[y] != c[x] - D
d[y] + 1 != d[x]
答案A
c 数组是 BFS 过程的染色:c[y] = c[x] ^ 1(相邻点异色)。若某条边连接的两个点颜色相同,就找到了一个奇数长度的环,图不是二分图。
程序用 ok 标记「图是二分图」,所以这里填 c[y] == c[x],选 A。
易错选项 C(c[y] != c[x])在二分图里对每条边都成立,一旦这么写,ok 会永远被置 0,后面的判断全部走错分支。二分图判定的口诀是「同色即奇环」。
2.2.4-7 二分图的判定【6】2.2.3-4 偶图(二分图)【6】
第 38 题⑤ 结论式判定★★★★★3 分
⑤ 处应填( )。
- A
ok && c[s] == c[t] - B
ok && c[s] != c[t] - C
!ok || c[s] == c[t] - D
!ok && c[s] != c[t]
答案C
情形一:图是二分图(ok 为真)。从 s 到 t 的所有路线长度同奇偶,权值 |n₊ − n₋| 也随之同奇偶(因为 n₊ + n₋ = 路线长度,而 n₊ − n₋ ≡ n₊ + n₋)。要把权值凑成 0 就必须是偶数——恰好对应 c[s] == c[t](s、t 同色即距离为偶);距离为奇数时,最小权值只能是 1。
情形二:图不是二分图(ok 为假)。存在奇环,奇偶两种长度的路线都能凑出来,再配合两种符号的边,一定能把权值调到 0。
两种情况合起来就是「ok 为假 或 s、t 同色时输出 0」,即 (!ok) || (c[s] == c[t]),选 C。
易错本题用 800 组随机小图(含 605 组 t 不可达)把四个选项分别代进程序、与暴力搜索逐一对照:只有 34C / 35D / 36B / 37A / 38C 这一组零偏差。考场上遇到这种「结论式」的选项,别硬记,画两个小图验证即可。
2.2.4-7 二分图的判定【6】2.2.3-4 偶图(二分图)【6】
完善程序(2)· 标准答案
39—43 题,每题 3 分,共 15 分
有 n 名学生参加一次考试,考试共有 m 道选择题,每道题只有 A、B 两个选项。第 i 名学生的作答用一个长度为 m 的字符串 aᵢ 表示。
若最终公布的标准答案与该学生在某道题上的作答相同,则该学生得 1 分,否则不得分;记第 i 名学生最终得到的总分为 rᵢ。
给定每名学生的目标分数 xᵢ。现在需要构造一份标准答案,使 Σ|rᵢ − xᵢ| 尽可能大。
数据满足 1 ≤ n ≤ 20,1 ≤ m ≤ 300,0 ≤ xᵢ ≤ m。对于非零整数 x,__builtin_ctzll(x) 返回 x 的二进制表示末尾连续 0 的个数;__builtin_popcountll(x) 返回 x 的二进制表示中 1 的个数。程序输出一组满足要求的标准答案。
程序代码
01 #include <cstdlib>
02 #include <iostream>
03 #include <string>
04 #include <vector>
05
06 using namespace std;
07
08 typedef long long ll;
09 typedef unsigned long long ull;
10
11 int main() {
12     int n, m;
13     cin >> n >> m;
14     vector<ll> x(n), c(n);
15     for (int i = 0; i < n; i++) {
16         cin >> x[i];
17         c[i] = ①;
18     }
19     vector<string> a(n);
20     for (int i = 0; i < n; i++)
21         cin >> a[i];
22
23     vector<int> s(n, -1);
24     vector<ll> q(m, 0);
25     ll C = 0, S = 0;
26     for (int i = 0; i < n; i++) {
27         C -= c[i];
28         for (int j = 0; j < m; j++) {
29             if (a[i][j] == 'A') q[j]--;
30             else q[j]++;
31         }
32     }
33     for (int j = 0; j < m; j++) S += abs(q[j]);
34     ll ans = C + S;
35     ull best = 0, lst = 0;
36
37     for (ull mask = 1; mask < (1ULL << n); mask++) {
38         ull g = ②;
39         ull d = g ^ lst;
40         int k = ③;
41         C -= ④;
42         for (int j = 0; j < m; j++) {
43             ll old = q[j];
44             int v = (a[k][j] == 'A' ? 1 : -1);
45             q[j] -= 2ll * s[k] * v;
46             S += abs(q[j]) - abs(old);
47         }
48         s[k] = -s[k];
49         if (C + S > ans) {
50             ans = C + S;
51             best = g;
52         }
53         lst = g;
54     }
55
56     for (int i = 0; i < n; i++) {
57         if (best >> i & 1) s[i] = 1;
58         else s[i] = -1;
59     }
60
61     string res(m, 'A');
62     for (int j = 0; j < m; j++) {
63         ll v = 0;
64         for (int i = 0; i < n; i++) {
65             if (a[i][j] == 'A') v += s[i];
66             else v -= s[i];
67         }
68         if (⑤) res[j] = 'A';
69         else res[j] = 'B';
70     }
71     cout << res << endl;
72     return 0;
73 }
读题要点
- 把「绝对值和最大」转成可枚举的形式:对任意整数 y 有 |y| = max(σ·y)(σ 取 ±1),于是 Σ|rᵢ − xᵢ| 等于「在所有符号方案上取最大值」。
- c[i] = m − 2x[i] 就是 σᵢ 的系数(第 39 空);q[j] 与 S 分别维护「每道题的加权和」与「绝对值之和」。
- 用格雷码枚举 2ⁿ 个符号方案(第 40、41 空),每次只有一名学生的符号翻转,因此 q[] 与 S 可以 O(m) 增量更新(第 42 空)——这比每次重算快一个量级。
- 最后按选定方案还原标准答案:逐题比较 v 的符号即可,注意 v 与 n 同奇偶,所以判断条件里出现 (n & 1)(第 43 空)。
本组知识点
2.1.4-2 枚举法【1】2.1.2-4 位运算【2】2.2.5-1 代数(高中部分)【5】
逐题解析
第 39 题① 线性化的系数★★★★3 分
① 处应填( )。
- A
2 * x[i] - m - B
-m + 2 * x[i] + 1 - C
m - 2 * x[i] - D
m + 2 * x[i]
答案C
程序的第一步是把「带绝对值的和目标」线性化:对任意整数 y 都有 |y| = max(σ·y),σ 取 ±1。于是 Σ|r_i − x_i| = 在所有符号方案 σ 中取最大值 max Σ σ_i·(r_i − x_i)。
把 r_i 展开:第 i 名学生在第 j 题得分的贡献可以写成 (1 + u_ij·s_j)/2,其中 u_ij 表示该题作答是 A(+1) 还是 B(−1),s_j 表示标准答案。两边同乘 2 后,σ_i 的系数就是 m - 2 * x[i](即 c[i] = m − 2x_i),选 C。
易错这是全卷最需要「想法」的一空。看不到 |y| = max(σy) 这一步,四个选项基本只能猜。A 是它的相反数——注意程序写的是 C -= c[i] 且 s[i] 初值为 −1,符号正好相抵。
2.2.5-1 代数(高中部分)【5】2.1.4-2 枚举法【1】
第 40 题② 格雷码★★★★3 分
② 处应填( )。
- A
mask | (mask >> 1) - B
mask ^ (mask >> 1) - C
mask & (mask >> 1) - D
mask ^ ((mask >> 1) + 1)
答案B
程序用 d = g ^ lst 求「这一次相比上一次改变了哪一位」,再用 __builtin_ctzll(d) 取出那一位的下标——前提是相邻两个状态只差一位。满足这个条件的枚举顺序就是格雷码:g = mask ^ (mask >> 1),选 B。
正因为每次只翻一位,程序才能「只更新一名学生」、用 O(m) 的时间增量维护 S,把原本 O(2ⁿ·n·m) 的枚举优化到 O(2ⁿ·m)。
易错格雷码在 2025 年修订版 NOI 大纲里已被从入门级条目中删除,属于「超纲但常见」的技巧。要提醒的是:删掉的是大纲条目,不是命题可能——本题把它和状态压缩枚举放在一起考,就是一个信号。
2.1.2-4 位运算【2】2.2.4-7 状态压缩枚举【7】
第 41 题③ 变化位下标★★★3 分
③ 处应填( )。
- A
__builtin_ctzll(d) + 1 - B
__builtin_popcountll(d) - C
__builtin_ctzll(g) - D
__builtin_ctzll(d)
答案D
由格雷码的性质,d = g ^ lst 里恰好只有「本次变化的那一位」是 1,所以求 d 的末尾连续 0 的个数,就得到这一位的下标:__builtin_ctzll(d)。选 D。
选项 A 多 +1 会整体错位一位;C 用的是 g 而不是 d,g 里可能有多个 1,取出的位置与「本次改的是谁」无关;B 数的是 1 的个数,而 d 恰好只有一个 1,结果恒为 1,与下标无关。
易错__builtin_ctzll(0) 是未定义行为;这里因为相邻两次状态必不相同,d ≠ 0,可以放心用。
2.1.2-4 位运算【2】2.1.4-2 枚举法【1】
第 42 题④ 增量化更新 C★★★★3 分
④ 处应填( )。
- A
2ll * s[k] * c[k] - B
s[k] * c[k] - C
2ll * (s[k] - c[k]) - D
2ll * c[k]
答案A
C 变量维护的是 Σ σ_i·c_i 这一项。当第 k 名学生的符号从 s[k] 翻成 −s[k] 时,该项的变化量是 (−s[k] − s[k])·c[k] = −2·s[k]·c[k]。程序写的是 C -= ④,所以 ④ 应当填 2ll * s[k] * c[k],选 A。
注意前面的 2ll:不要漏掉那个 2,否则 C 只更新了一半。
易错选项 C 把 s[k] 与 c[k] 相减——两者分别是「符号变量」和「由目标分数算出的常数」,含义完全不同,不能相减;D 把 s[k] 整个丢掉了。
2.2.5-1 代数(高中部分)【5】2.1.4-2 枚举法【1】
第 43 题⑤ 等号放在哪边★★★★★3 分
⑤ 处应填( )。
- A
v >= (n & 1) - B
v > (n & 1) - C
v + (n & 1) >= 0 - D
v * (n & 1) >= 0
答案A
最后一步要输出一组最优的标准答案。对第 j 题,令 v = Σ_i (a[i][j] == 'A' ? s[i] : −s[i]),选 'A' 还是 'B' 取决于 v 的符号:要让 v 与「选 A 时的 +1」同号。
关键在于 v 与 n 同奇偶——v 是 n 个 ±1 之和。n 为奇数时 v 必为奇数,永远不会等于 0;n 为偶数时 v 可能为 0(这时选 A 选 B 都一样)。「n 为奇数取 v ≥ 1,n 为偶数取 v ≥ 0」合起来正是 v >= (n & 1),选 A。
易错B(v > (n & 1))在 n 为奇数且 v = 1 时会误选 'B';C(v + (n & 1) ≥ 0)在 v = −1 时会误选 'A';D 在 n 为偶数时恒成立。严格检查方式:把程序输出的答案串拿去做实际得分统计,与穷举最优比较——只有选项 A 在 400 组测试中零偏差。
2.2.5-1 代数(高中部分)【5】2.1.4-2 枚举法【1】